9. Lire un document
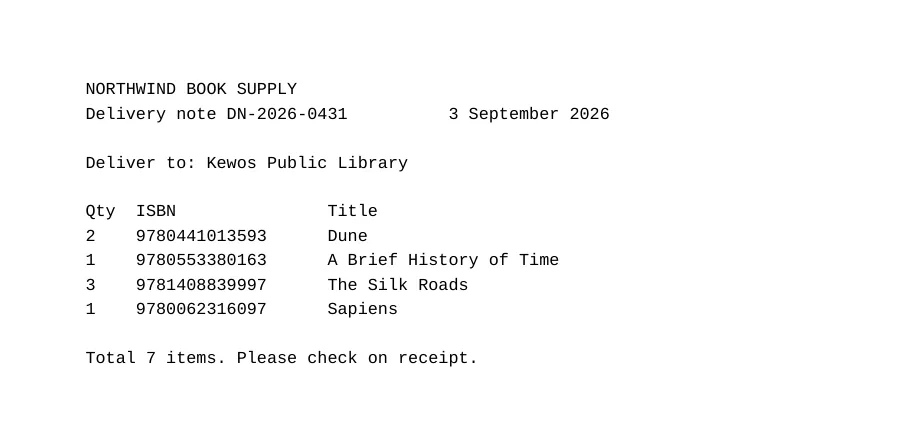
Une bibliothécaire reçoit un carton et un bon de livraison. Plutôt que de retaper les ISBN, on lit le document.
Où passe la frontière
kewos/ocr transforme un document en texte, et s’arrête là. Il ne sait pas ce qu’est un
ISBN, et il ne doit pas le savoir : reconnaître un ISBN est une connaissance métier, donc elle
vit dans le module.
C’est la même frontière que partout ailleurs dans ce produit. Le noyau fournit une capacité générique, le module y met son sens.
Lire
from kewos.ocr import extract_text
result = extract_text(    document,    mime_type="application/pdf",    default=tenant_default,      # the tenant's ocr.engine parameter    fallback=tenant_fallback,)
Le module ne nomme aucun moteur : il transmet ce que le client a configuré. Le choix appartient à l’installation, pas au code.
Sur le bon de livraison ci-dessus, avec le moteur pdf_text :
moteur : pdf_text | repli : False--- texte extrait ---NORTHWIND BOOK SUPPLYDelivery note DN-2026-0431 3 September 2026Deliver to: Kewos Public LibraryQty ISBN Title2 9780441013593 Dune1 9780553380163 A Brief History of Time3 9781408839997 The Silk Roads1 9780062316097 SapiensTotal 7 items. Please check on receipt.Exact, instantané, gratuit : le PDF portait déjà son texte, il n’y a pas eu d’OCR du tout.
Reconnaître
#: An ISBN-13 as printed: thirteen digits, optionally grouped by spaces or#: hyphens. Deliberately narrow -- a looser pattern matches phone numbers and#: order references, and a wrong match is worse than a missed one here._ISBN13 = re.compile(r"\b(97[89])[-\s]?(\d[-\s]?){9}\d\b")

def is_valid_isbn13(isbn: str) -> bool:    """Check the ISBN-13 checksum."""    digits = re.sub(r"[-\s]", "", isbn)    if len(digits) != 13 or not digits.isdigit():        return False    total = sum(int(d) * (1 if i % 2 == 0 else 3) for i, d in enumerate(digits[:12]))    return (10 - total % 10) % 10 == int(digits[12])
Le résultat garde la ligne d’où il vient, pour que la personne qui vérifie voie un contexte et pas un nombre nu :
9780441013593 <- 2 9780441013593 Dune 9780553380163 <- 1 9780553380163 A Brief History of Time 9781408839997 <- 3 9781408839997 The Silk Roads 9780062316097 <- 1 9780062316097 SapiensEt si le document est une photo
Le même code, un autre moteur. Voici ce que le moteur local a lu sur la même page, rendue en image à 200 points par pouce :
NORTHWIND BOOK SUPPLYDelivery note DN-2026-0431 3 September 2026
Deliver to: Kewos Public Library
Qty ISBN Title
2 9780441013593 Dune
1 9780553380163 A Brief History of Time3 9781408839997 The Silk Roads
1 9780062316097 Sapiens
Total 7 items. Please check on receipt.
L’alignement en colonnes a disparu, des lignes vides se sont ajoutées, et les quatre ISBN sortent identiques. C’est pour cela que la reconnaissance travaille ligne par ligne avec une expression, et jamais sur des positions de colonnes.
Le cas qui compte : un scan
Un PDF scanné ne porte aucune couche de texte. Le moteur le dit, au lieu de répondre « rien trouvé » :
from kewos.ocr import NoTextLayerError
try: lines = read_delivery_note(document, mime_type="application/pdf", default="pdf_text")except NoTextLayerError: # Not a failure: an answer. Ask for an image engine, or ask the supplier # for a real PDF. ...Où faire cet appel
Pas dans une requête HTTP. Une lecture est lente, et côté IA elle sort sur le réseau. Mettez-la dans un traitement de fond, et laissez l’écran afficher l’attente.
Et ensuite
Les documents PDF : produire un document plutôt que d’en lire un.